
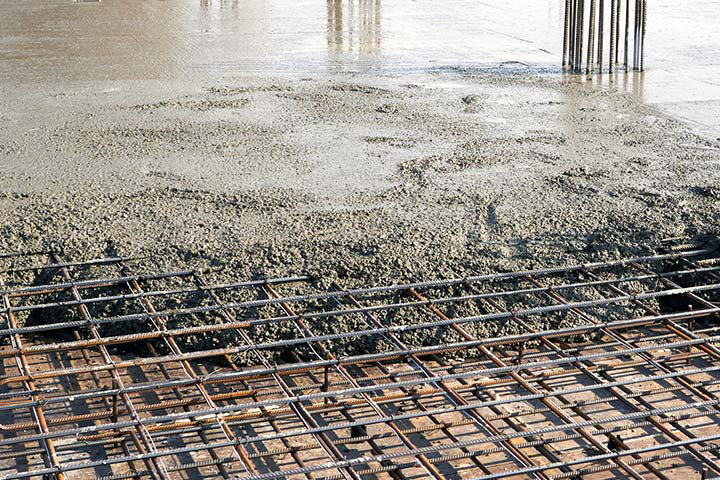
مراحل آرماتور بندی در ساخت و ساز
مراحل آرماتور بندی در ساخت و ساز
آرماتوربندی
جهت حفاری به روش پایپ جکینگ با ما در ارتباط باشید 09012040741
پایپ جکینگ یک تکنیک پیشرفته جهت نصب لوله های زیرزمینی ، کانالها و لوله های مخصوص برق و مخابرات می باشد.
آراز تکنیکال پیمانکار برتر حفاری به روش پایپ جکینگ
آموزش یادگیری عمیق (DL) سخت است و یادگیری تقویتی (RL) بسیار بدتر است.
در مراحل اولیه توسعه، همان استراتژی را برای DL دنبال کنید:
همه چیز را ساده نگه دارید! هر زنگ و سوتی که سر راه شما قرار می گیرد را حذف کنید و عدم اطمینان را به حداقل برسانید.
به طور خاص برای RL،
برای مدل ها و الگوریتم های جدید، آزمایش(های) اسباب بازی ساده را برای توسعه اولیه انتخاب کنید.
ابتدا مسئله را ساده کنید تا بتوانیم آزمایش ها را به راحتی و سریع اجرا کنیم.
صبر با تنظیم هایپرپارامتر. RL به هایپرپارامترها (بدتر از DL) بسیار حساس است.
دانه های تصادفی مختلف را امتحان کنید.
کم هدف بگیرید همیشه از چیزی که کار می کند کار کنید.
مرجع تنظیم کنید
بسیاری از الگوریتمهای بدون مدل، قبل از نشان دادن هر نشانهای از پیشرفت، یک دوره گرم کردن طولانی دارند.
اغلب، قبل از دیدن برخی حرکتهای امیدوارکننده، میلیونها تکرار انجام میدهند.
برای مقابله با عدم قطعیت، یک روش موثر این است که با آزمایش های اسباب بازی با استفاده از روش های دیگر RL آشنا شوید.
سپس از آنها برای ارجاع متقابل به پیشرفت خود استفاده می کنیم. به عنوان مثال، آیا اقدامات یا پاداش ها در این زمان از آموزش عادی به نظر می رسند؟
به عنوان مثال زیر، نمودار پیشرفت تمرین انبوه را با استفاده از روش های مختلف DQN در 57 بازی آتاری نشان می دهد.
این به ما دستورالعمل هایی در مورد زمان ادامه آموزش و زمان شروع اشکال زدایی در توسعه روش های DQN مانند می دهد.
ویژگی های ورودی
ابتدا کارها را آسان تر کنید. اگر یادگیری از پیکسل های خام کند است، ابتدا از ویژگی های دست ساز استفاده کنید.
به عنوان مثال، به جای استنباط از پیکسل های خام، از حالت های جمع آوری شده از بازوهای ربات یا مکان های اشیای مشاهده شده استفاده کنید.
ابعاد بالای تصاویر پیچیدگی قابل توجهی را به مشکلات اضافه می کند.
بازیهای Atari قوانین بازی نسبتاً سادهای دارند و با شبکههای CNN در استخراج ویژگیهای عمومی به خوبی کار میکنند.
این ممکن است برای سایر وظایف RL صادق نباشد.
RL دقیقاً یادگیری عمیق نیست
متأسفانه، بسیاری از موفقیت ها در DL مانند یادگیری نظارت شده به راحتی در RL تکرار نمی شوند.
اجازه دهید برخی از مسائل را پوشش دهیم.
i.i.d.
یک تفاوت عمده بین DL و RL توزیع داده ورودی آموزشی آن است.
در DL، ما ورودی را تصادفی می کنیم به طوری که هر دسته از داده های آموزشی دارای تعادل خوبی از کلاس های مختلف اشیاء است و هر نمونه مستقل از دیگری است.
ما نمیتوانیم آنچه را که ممکن است بعداً از نمونههای قبلی ببینیم، پیشبینی کنیم.